CloudFormationでAWS上にDify環境を自動構築するで作った環境に、自分のブログ記事341本をナレッジとして取り込み、質問すると記事を引用して答えるチャットボットを作りました。
手順自体は「ナレッジを作る・文書を入れる・アプリに紐付ける」の3つだけです。ところが実際にやってみると、Difyの画面で選べるモデルがBedrockでは呼べないという問題に二度はまりました。しかも片方は画面にエラーが出ず、返答が空になるだけです。
本記事は、東京リージョンで実際に構築しながら確認した記録です。
1. 完成したもの
- ナレッジベース: 公開記事341本(約61万トークン)
- 埋め込みモデル:
cohere.embed-multilingual-v3 - LLM: Amazon Bedrock 経由の Anthropic Claude
- 検索方式: ベクトル検索(高品質インデックス)
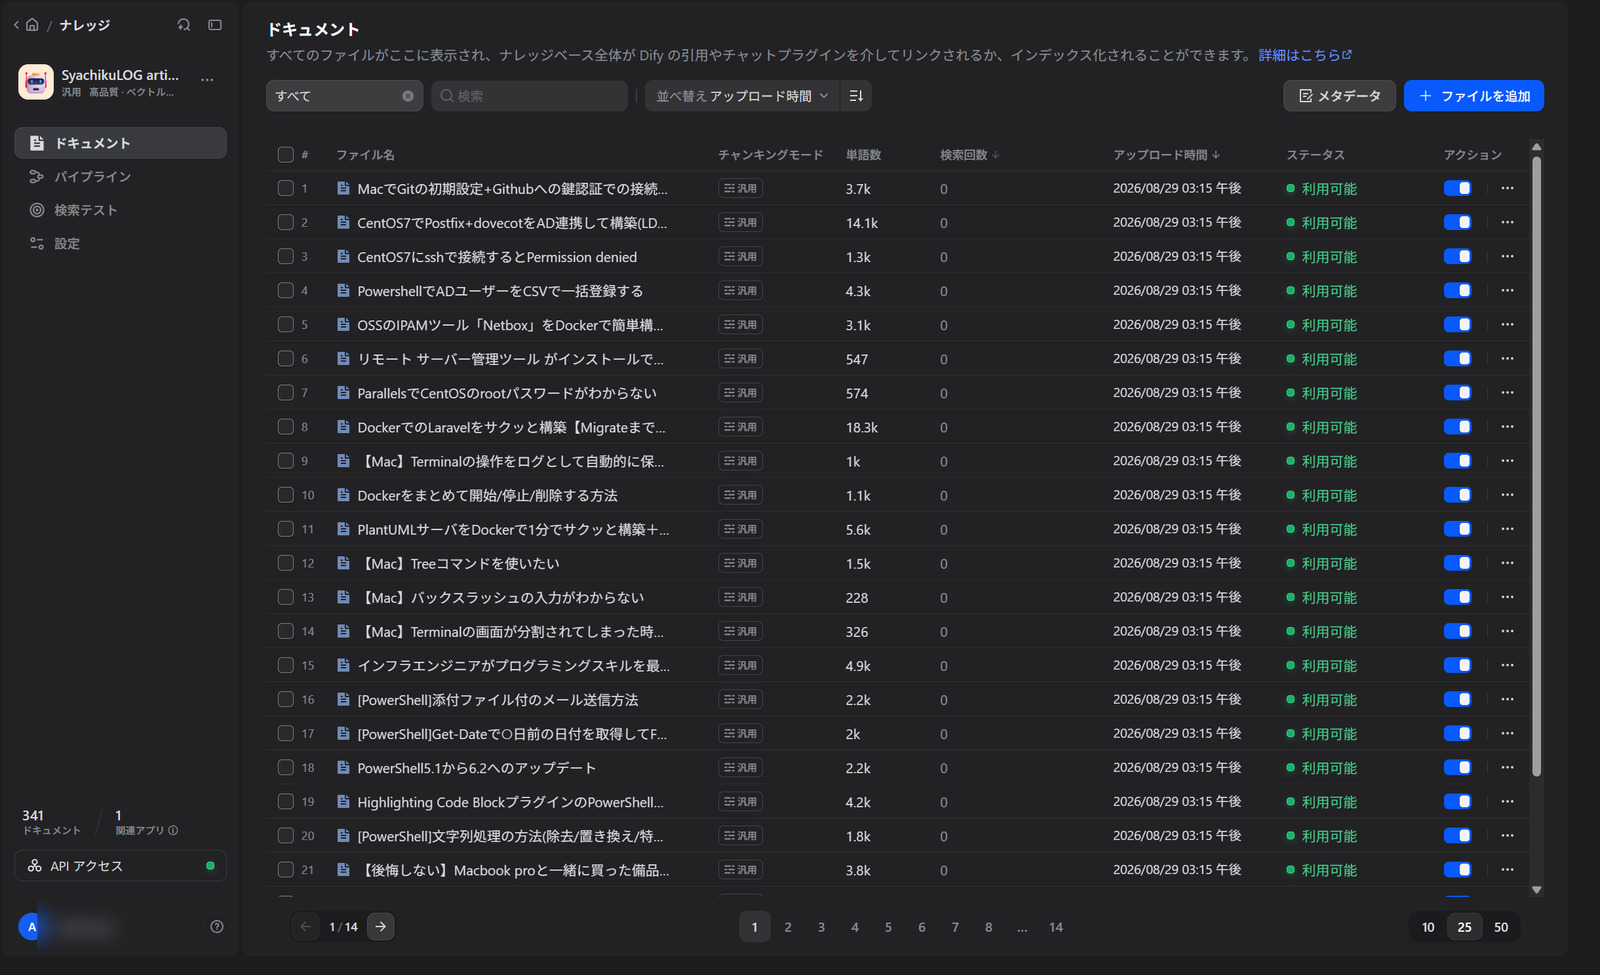
「CloudFormationでEC2のUserDataを変更すると再起動されますか?」と聞くと、該当する記事を検索したうえで回答し、末尾に参考記事のタイトルを挙げてくれます。ブログに書いていないことを聞くと「該当する情報が見つかりませんでした」と答えるように、プロンプトで縛ってあります。
2. 記事をMarkdownで書き出す
まずWordPressの公開記事をローカルにMarkdownで書き出します。REST APIで本文を取得し、1記事1ファイルで保存するだけです。
# 公開記事を取得して knowledge/<id>-<slug>.md に書き出す
import requests, html2text

r = requests.get(f"{WP_URL}/wp-json/wp/v2/posts",
                 params={"per_page": 100, "page": page, "status": "publish"},
                 auth=auth, timeout=60)
for p in r.json():
    body = html2text.HTML2Text().handle(p["content"]["rendered"])
    path = KNOWLEDGE_DIR / f'{p["id"]}-{p["slug"]}.md'
    path.write_text(f'# {p["title"]["rendered"]}\n\n{body}', encoding="utf-8")
1行目を # タイトル にしておくのがポイントです。Difyの文書名にこの行を使うと、管理画面の一覧で何の記事か判別できます。
3. 画面からのアップロードは5ファイルまで
書き出した341本をDifyに入れます。ここで最初の壁がありました。
ナレッジ作成画面のアップロード欄には、こう書かれています。
TXT, HTM, XLS, XLSX, DOCX, CSV, PDF, HTML, MARKDOWN, VTT, MDX, MD をサポートしています。
1バッチあたり最大5ファイル、各ファイル15MB まで。1回に5ファイルです。341本なら69回繰り返すことになり、現実的ではありません。数百件を入れるならナレッジAPI一択です。
APIキーは、ナレッジ画面の左下「APIアクセス」から発行します。あとは1ファイルずつPOSTするだけです。
payload = {
    "name": first_line[:100],          # 1行目の見出しを文書名にする
    "text": text,
    "indexing_technique": "high_quality",
    "process_rule": {"mode": "automatic"},
}
requests.post(f"{url}/v1/datasets/{dataset_id}/document/create-by-text",
headers=headers, json=payload, timeout=120)なお、空のナレッジベースはアプリのコンテキスト候補に出てきません。 文書を1件も入れていないと選択肢に現れないので、先に投入してから紐付ける順序になります。
4. 埋め込みが全件エラーになった
10本で試したところ、登録は成功したのにインデックスが全件エラーになりました。
インデックス状況: {'error': 10}エラーの中身を見ると、Bedrockプラグインからの例外でした。
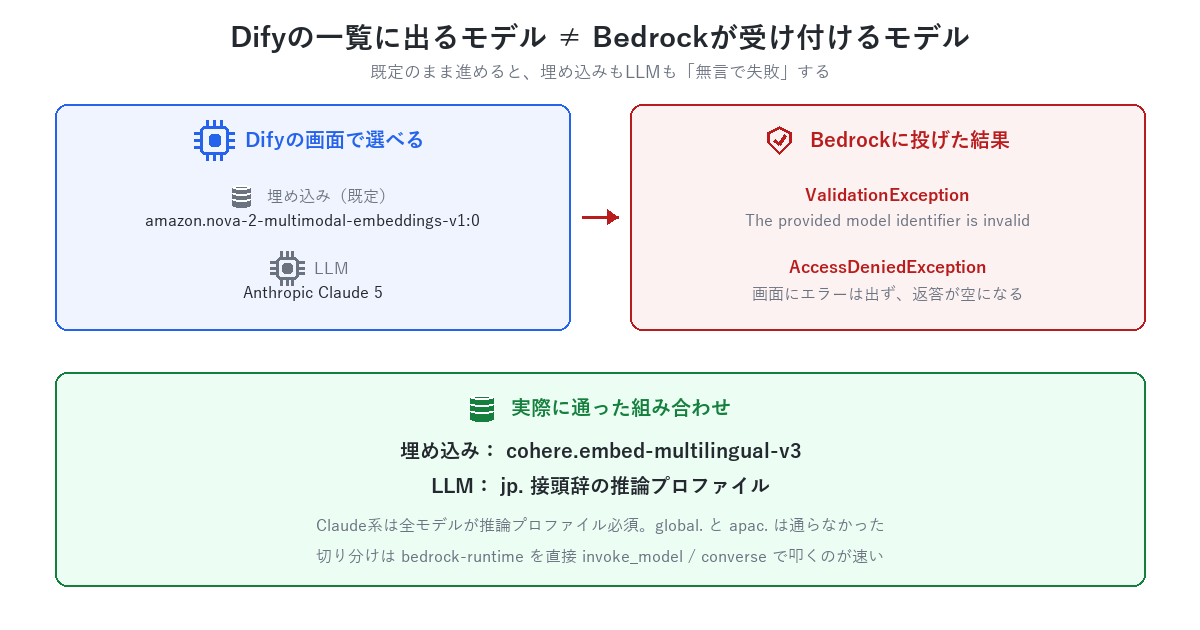
[models] Error: ValidationException: The provided model identifier is invalid.ワークスペースの既定の埋め込みモデルは amazon.nova-2-multimodal-embeddings-v1:0 になっていました。Difyの設定画面のドロップダウンに出ていたので、当然使えるものだと思っていました。
5. 画面に出るモデルと呼べるモデルは違う
Bedrock側で利用可能な埋め込みモデルを一覧すると、答えははっきりしていました。
# 出力が埋め込みのモデルだけを絞って一覧する
aws bedrock list-foundation-models --region ap-northeast-1 \
  --by-output-modality EMBEDDING \
  --query "modelSummaries[].modelId" --output table
cohere.embed-v4:0
amazon.titan-embed-text-v1
amazon.titan-embed-text-v2:0
cohere.embed-english-v3
cohere.embed-multilingual-v3amazon.nova-2-multimodal-embeddings-v1:0 は入っていません。 Difyのプラグインはドロップダウンに出しますが、このリージョンのこのアカウントでは呼べないモデルでした。
念のため、実際に投げて確かめます。一覧に出るかどうかではなく、投げて通るかで判断するのが確実です。
import boto3, json
rt = boto3.client("bedrock-runtime", region_name="ap-northeast-1")

# Cohere と Titan はリクエストの形が違うので分けて試す
tests = [
    ("cohere.embed-multilingual-v3", {"texts": ["テスト"], "input_type": "search_document"}),
    ("amazon.titan-embed-text-v2:0", {"inputText": "テスト"}),
    ("amazon.nova-2-multimodal-embeddings-v1:0", {"inputText": "テスト"}),
]
for model_id, body in tests:
    try:
        rt.invoke_model(modelId=model_id, body=json.dumps(body))
        print("OK  ", model_id)
    except Exception as e:
        print("NG  ", model_id, type(e).__name__)
OK cohere.embed-multilingual-v3 次元数=1024
OK amazon.titan-embed-text-v2:0 次元数=1024
NG amazon.nova-2-multimodal-embeddings-v1:0 ValidationException日本語の記事を扱うので、多言語対応の cohere.embed-multilingual-v3 を採用しました。
6. ナレッジの設定はAPIから変える
埋め込みモデルはナレッジベースの「設定」画面で変更できます。ところが画面で選び直しても保存されませんでした。 APIで確認すると既定値のままです。
埋め込みモデル : amazon.nova-2-multimodal-embeddings-v1:0ナレッジAPIの PATCH を使ったところ、こちらは確実に反映されました。
body = {
    "name": "SyachikuLOG articles",
    "indexing_technique": "high_quality",
    "embedding_model": "cohere.embed-multilingual-v3",
    "embedding_model_provider": "langgenius/bedrock/bedrock",
}
requests.patch(f"{url}/v1/datasets/{dataset_id}", headers=headers, json=body, timeout=60)
embedding_model_provider にプラグインの識別子(langgenius/bedrock/bedrock)を渡す必要がある点に注意してください。
差し替え後に入れ直したところ、10本すべて completed になりました。エラーになった文書は消してから入れ直します。 埋め込みモデルを変えても既存文書は再インデックスされません。
7. LLMも同じ罠だった
ナレッジが通ったのでアプリを作り、モデルに「Anthropic Claude 5」を選んで質問を投げました。ところがいつまで待っても返答が返りません。
エラーは表示されず、回答欄が空のままです。ログには記録が残るものの、画面上は何が起きたのか分かりません。
Claude系のモデルを直接叩いて切り分けました。
rt = boto3.client("bedrock-runtime", region_name="ap-northeast-1")
for m in ["anthropic.claude-sonnet-5",
          "global.anthropic.claude-sonnet-5",
          "jp.anthropic.claude-sonnet-4-6"]:
    try:
        rt.converse(modelId=m, messages=[{"role": "user", "content": [{"text": "ping"}]}],
                    inferenceConfig={"maxTokens": 16})
        print("OK  ", m)
    except Exception as e:
        print("NG  ", m, type(e).__name__)
NG anthropic.claude-sonnet-5 AccessDeniedException
NG global.anthropic.claude-sonnet-5 AccessDeniedException
OK jp.anthropic.claude-sonnet-4-6list-foundation-models を見ると理由が分かります。Claude系はすべて INFERENCE_PROFILE のみで、ON_DEMAND がありません。
anthropic.claude-sonnet-5           INFERENCE_PROFILE
anthropic.claude-sonnet-4-6         INFERENCE_PROFILE
anthropic.claude-opus-4-8 INFERENCE_PROFILE素のモデルIDでは呼べず、推論プロファイル経由が必須です。さらに接頭辞にも差があり、この環境で通ったのは jp. だけでした(global. と apac. はいずれも失敗)。Difyのモデル一覧を「Anthropic Claude 5」から「Anthropic Claude」に変えたところ、通るようになりました。
Bedrock側でモデルが呼べないときの切り分けはBedrockでモデルが呼べないときの切り分けに詳しくまとめています。IAMロールでの認証設定はDifyにAWS Bedrockを設定するを参照してください。
8. アプリの設定は「公開する」まで保存されない
もうひとつ、時間を溶かした挙動があります。
プロンプト・モデル・コンテキストを設定したあと別の画面へ移動して戻ったら、設定がすべて消えていました。 チャットボットの設定は下書き状態で保持されず、右上の「公開する」を押すまで永続化されません。
設定を変えたら、画面を離れる前に必ず「公開する」を押す。 これだけで一度やり直す手間が防げます。
9. 一括インデックス中は環境が飽和する
341本を投入したあと、インデックス作成は非同期で進みます。ここで環境の負荷が問題になりました。
EC2 CPU使用率:  9% → 37% → 72%
インデックス:   waiting 120 / indexing 4 / completed 217
t3.large で341本ぶんの埋め込みを生成している間、チャットの応答が返ってきません。 LLM呼び出しがワーカーの後ろで詰まるためです。341本の完了までおよそ6分かかりました。
検証環境なので待てば済みますが、業務で使っているDifyに大量の文書を入れるなら、業務時間外に回すか、投入中はインスタンスを一段上げる判断が要ります。
10. 動作確認
実際の編集画面です。左がプロンプトとコンテキストの設定、右がデバッグ用のプレビューになります。
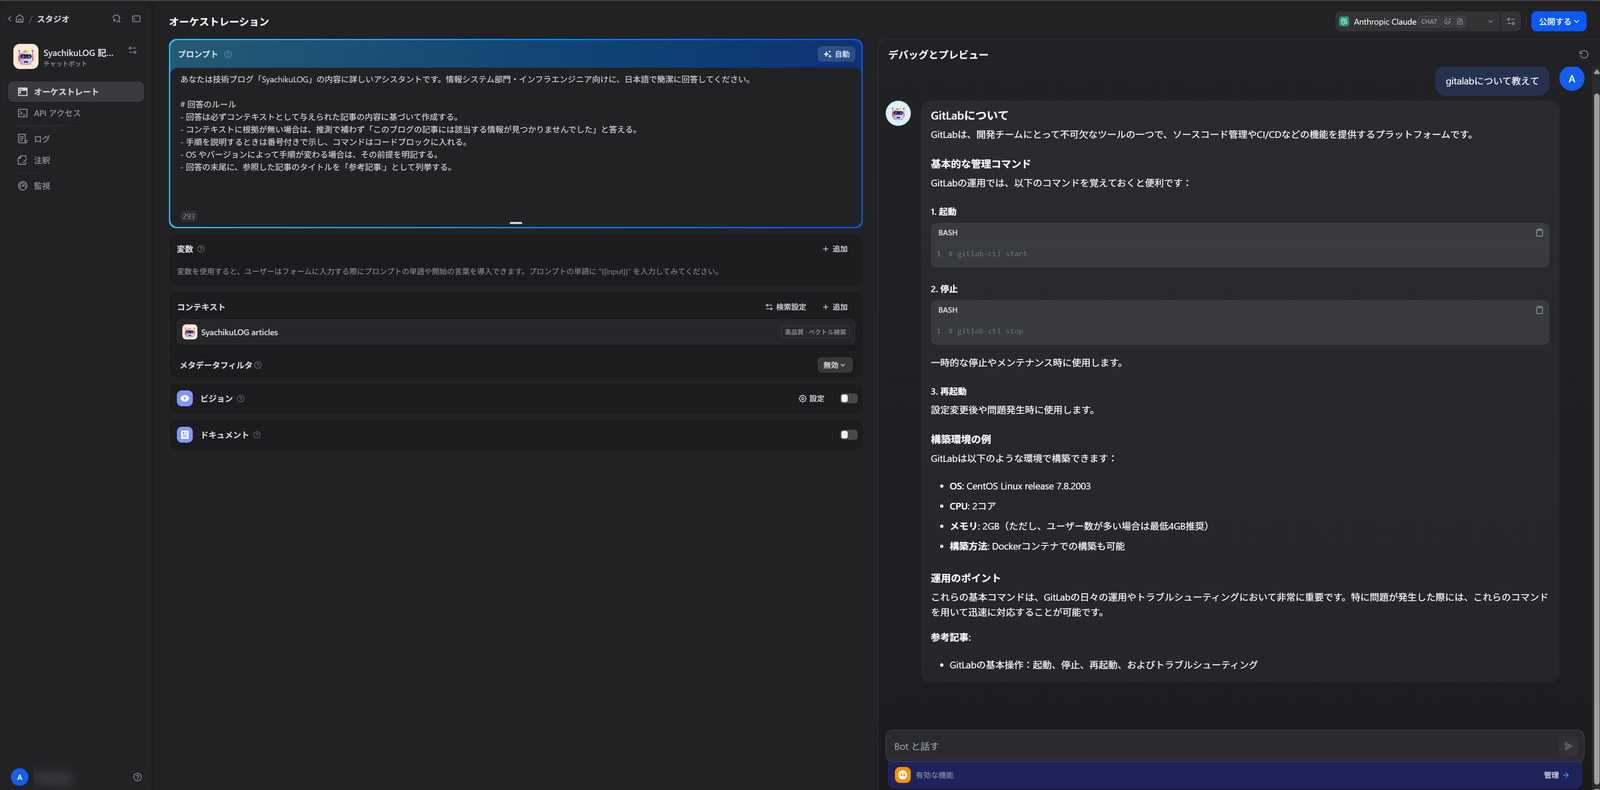
「gitlabについて教えて」と聞くと、ブログ内のGitLab記事から起動・停止コマンドや構築環境(CentOS 7.8 / 2コア / メモリ2GB)まで引いて回答し、末尾に参考記事を挙げました。自分が書いた内容がそのまま根拠として返ってくる点が、汎用のチャットAIとの違いです。
インデックス完了後にCloudFormationについて質問したときは、8.12秒・1,805トークンで回答が返りました。参考記事のタイトルも指示どおり列挙されています。
ブログに書いていないことを聞いた場合も確認しました。
Q: Kubernetes の Istio でカナリアリリースを設定する手順を教えてください。
A: このブログの記事には、Istio を使った Kubernetes でのカナリアリリースの具体的な設定手順に関する情報が見つかりませんでした。
でっち上げずに「無い」と答えました。 そのうえで、コーパス内で見つかった「カナリアリリースの概念」だけは提示しています。プロンプトで根拠のない回答を禁じておくと、この挙動になります。
10.1 RAGの精度はコーパスの鮮度が上限
ひとつ重要な発見がありました。UserDataに関する回答が「置き換え(再作成)になります」となったのですが、これは古い記事にそう書いてあるからです。実際にはルートボリュームがEBSなら再起動で済みます。
ボットは間違っていません。与えたコーパスに忠実なだけです。書き出しを実行した時点の記事しか入っていないので、記事を更新したら書き出しと投入をやり直す運用が要ります。
自分のブログをRAG化すると、この「古い記述が残っている」問題が可視化されるという副次的な効果もありました。
11. まとめ
Difyのナレッジ機能で自分の文書をRAG化するときの要点です。
- 画面アップロードは1バッチ5ファイル。数百件ならナレッジAPI一択
- Difyのドロップダウンに出るモデルが、Bedrockで呼べるとは限らない
- 既定の埋め込みモデルが呼べず全件インデックスエラーになった
- LLMは画面にエラーが出ず、回答が空になるだけ。ログを見るまで気づけない
- Claude系は推論プロファイル必須。通る接頭辞は環境によって違う(今回は
jp.のみ) - 切り分けは
bedrock-runtimeを直接叩くのが速い。一覧に出るかではなく、投げて通るかで判断する - ナレッジ設定の画面変更が保存されないことがある。Dataset APIの
PATCHなら確実 - アプリ設定は「公開する」まで永続化されない
- 一括インデックス中はt3.largeが飽和してチャットが使えない
一番の教訓は、Difyの画面はBedrockの実際の可用性を検証していないということです。選べてしまうので気づけません。埋め込みは全件エラーという派手な形で出ましたが、LLM側は無言で失敗するぶん厄介でした。
新しい環境でDifyとBedrockを繋ぐときは、アプリを作る前に、使うつもりのモデルをbedrock-runtimeで1回叩いておく。これだけで今回の遠回りは避けられました。
Dify環境の構築についてはCloudFormationでAWS上にDify環境を自動構築する、ファイルストレージのS3化についてはDifyのファイルストレージをS3にするで解説しています。
AWSを効率的に学習する方法
私が効率的にAWSを学習するために実施した方法は以下の通りです。
①最初に書籍(ハンズオンができる)を購入、座学でAWSの基礎を学習
②AWS資格試験を取得ための学習
※私の場合は①と②を合わせて2か月でソリューションアーキテクトを取得できました。
①AWS基礎学習
最初に購入した書籍は「Amazon Web Services 基礎からのネットワーク&サーバー構築」です。
Amazon Web Services 基礎からのネットワーク&サーバー構築 改訂4版

この本では、AWSの基本サービスを利用したハンズオンを通じて、AWSの基礎を学習することができます。
また、タイトル通りAWSのネットワークやインフラに関しても網羅しているため、もともとインフラ系の技術者ではない人たちにとっても分かりやすい内容だと思います。
とりあえずAWS上にサーバーを設定して開発を行うための準備までするには最良の一冊です。
Amazon Web Services 基礎からのネットワーク&サーバー構築 改訂4版
②AWS資格取得
AWSの基礎をある程度学習することができたら、次はAWS資格を取得しましょう。まずはAWSソリューションアーキテクトを目指しましょう。

資格勉強のための問題集をひたすら解きながら、AWSの知識を積み重ねて習得していきましょう!
苦行ではありますが、この問題集を3周ほどすればAWS用語や構成に関しても習得できているはずです。
独学だと手が止まってしまう場合は、ササエル のようなインフラエンジニア向けのオンラインスクールを使う手もあります。ネットワークやサーバーの分野に絞ったカリキュラムなので、業務でインフラを触る人が学び直すのにも使えます。
コメント