

AIエージェントに実際の業務データを触らせるとき、指示書(Claude Code なら CLAUDE.md)に注意事項を書き並べます。ただ、「やるな」と書くだけでは事故は止まりませんでした。
公開記事368本のWordPressを6週間触らせた結果、意図しない2記事に広告が入り、更新のたびに消える要素があり、画面キャプチャに関係ないウィンドウが2回写りました。
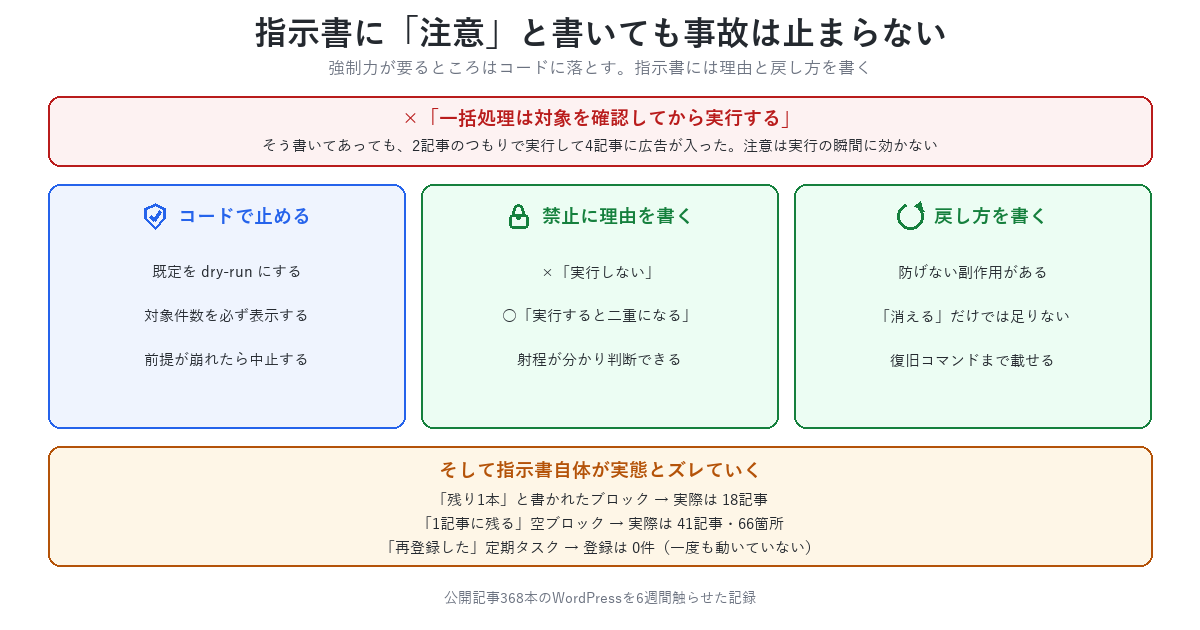
この記事では、実際に起きた事故から逆算して、指示書に書くこととスクリプトに実装することの書き分けを整理します。Claude Code を例にしていますが、指示書を読ませる形式のエージェントであれば考え方は同じです。
1. 結論:指示書には「止め方」と「戻し方」を書く
先に結論です。指示書に書いて効いたのは次の3つでした。
- 破壊的な操作は、指示書ではなくスクリプト側で止める
- 禁止には必ず理由を書く(理由のない禁止はいつか破られる)
- 「消えるもの」には復旧手順をセットで書く
逆に、効かなかったのが「〜に注意すること」という書き方です。注意は状態を持たないので、実行の瞬間には効きません。
2. 何をやらせていたか
前提として規模を書いておきます。
| 項目 | 値 |
|---|---|
| 対象 | WordPress(公開記事368本) |
| 期間 | 約6週間 |
| 作業 | 記事の執筆・投入、既存記事の一括書き換え、図の生成、流入分析 |
| 指示書 | CLAUDE.md 約65KB |
一括書き換えが入るのが要点です。1記事ずつの作業なら間違えても1件で済みますが、REST API で回すスクリプトは数十件を一度に書き換えます。
3. 型①:破壊的な操作はスクリプト側で止める
3.1 起きたこと
再利用ブロック(複数記事で共有する広告ブロック)を2記事に入れ直すつもりで一括投入スクリプトを実行したところ、プランに載っていて未設置だった別の2記事にも同時に設置されました。
スクリプトの仕様としては正しい動作です。対象が「プラン全体」だったのに、こちらが「今指定した2件」のつもりでいた、という認識のズレでした。
3.2 指示書だけでは止まらない
このとき指示書には「一括処理は対象を確認してから実行する」と書いてありました。それでも起きました。 実行の瞬間に対象件数を数える動作が、どこにも組み込まれていなかったためです。
3.3 スクリプト側に入れた3つ
そこで、書き換え系のスクリプトを次の形に統一しました。
# 既定は dry-run。--apply を明示したときだけ書き込む
ap.add_argument("--apply", action="store_true")
args = ap.parse_args()

# ...対象を集めて件数を出す...
print(f"\n対象 {len(jobs)}本 / 箇所 {total}")
if not args.apply:
    print("dry-run です。実際に実行するには --apply を付けてください。")
return- 既定を dry-run にする。 引数を忘れたときに何も起きないほうへ倒す
- 対象件数を必ず表示する。 「2件のつもりが41件だった」を実行前に気づける
- 書き換え前の状態をファイルに退避する。 戻せるようにしておく
さらに、スクリプトごとに中止条件を足しました。たとえば「中身が空のブロックへの参照を外す」スクリプトには、次の判定を入れています。
# 空であることを確認してから進む。中身があるブロックは絶対に触らない
for bid in BLOCKS:
    body = get_block(bid)["content"]["raw"].strip()
    if body:
        print(f"中止: ブロック {bid} には中身があります。空のものだけが対象です。")
return前提が崩れていたら何もせずに終わるという作りです。実際、この安全弁があったので41記事・66箇所の書き換えを不安なく実行できました。
4. 型②:禁止には理由を書く
指示書には、実行してはいけないスクリプトがいくつかあります。最初は次のように書いていました。
- add_pr_notice.py は実行しないこれは危険な書き方でした。理由が書かれていない禁止は、状況が変わったときに判断できません。半年後の自分も、エージェントも、「なぜダメなのか」が分からないまま実行しかねません。
いまは理由とセットにしています。
**PR表記はウィジェットで全記事に出している。**
`add_pr_notice.py --apply` を実行すると二重表記になる。実行しないこと。「二重表記になる」という結果が書いてあれば、ウィジェットをやめた場合には実行してよいと判断できます。禁止の射程が分かるわけです。
同じ理由で、「AWSリソースを勝手に作成・変更・削除しない」にも 実費が発生する という理由を添えています。
5. 型③:「消えるもの」には復旧手順を書く
5.1 毎回起きる事故がある
記事をMarkdownから再投入すると、本文が作り直されます。そのためWordPress側で後から挿入した再利用ブロックが消えます。Markdown側にその記述は無いので、更新のたびに必ず起きます。
これは仕様なので、防ぐことはできません。1本の記事で2回連続して踏みました。
5.2 禁止ではなく手順にする
防げない以上、書くべきは「注意」ではなく復旧手順です。
# 更新 → ブロック再設置 の順で実行する
echo y | .\.venv\Scripts\python.exe post_draft.py articles/xxx.md --post
echo y | .\.venv\Scripts\python.exe add_amazon_block.py --apply指示書には、この2行をセットで載せています。「消える」という事実だけを書くと、読んだ側は身構えるだけで終わります。 手順まで書いて初めて復旧できます。
なお、公開だけを行う操作は本文を作り直さないため、ブロックは残ります。同じ「更新」でも、本文を作り直す操作とそうでない操作を区別して書く必要がありました。
6. 「絶対に守ること」は先頭に4項目だけ
65KBの指示書のうち、先頭に置いているのは4項目だけです。
- 公開しない(下書きまでで止める。公開は別操作で、明示的に指示されたときだけ)
- 個人情報を出さない(検査に引っかかったら、検査を緩めるのではなく中身を直す)
- AWSリソースを勝手に作成・変更・削除しない(実費が発生する。参照のみ)
- 既存記事と重複するテーマを書かない
2番目の書き方が実務的に効きました。「検査を緩めるのではなく」と明記しているのは、エラーを解消する最短経路が「検査を甘くする」ことだからです。目的を達成する近道が安全装置の解除である場合、そこを先回りして塞いでおく必要があります。
項目を増やさないのも意図的です。20個並べると、全部が等しく重要に見えて優先順位が消えます。
7. 指示書は腐る
ここが一番の落とし穴でした。指示書の記述と実態は、放っておくとズレます。
6週間分の記述を実測で突き合わせたところ、次の乖離が見つかりました。
| 指示書の記述 | 実測 |
|---|---|
| ブロック3628は「残り1本」 | 18記事に設置されていた |
| 空ブロックは「1記事に残る」 | 41記事・66箇所に残っていた |
| 定期タスクを「再登録した」 | 登録は0件(一度も動いていなかった) |
どれも、書いた時点では正しかったはずの記述です。その後の作業で状態が変わったのに、指示書が追随していませんでした。
とくに3つ目が厄介で、「再登録した」と書いてあるのを信じて、動いている前提で2週間過ごしていました。指示書は読む側にとって事実として扱われるので、間違った記述は注意書きより有害です。
7.1 手で突き合わせるのは続かない
対策は「定期的に実測と突き合わせる」ですが、手作業の見直しは続きません。気づいたときにやる運用は、気づかなかったときに何も起きません。
そこで、突合そのものをスクリプトにしました。機械的に照合できるのは次の3点です。
| 見るもの | 照合の中身 |
|---|---|
| スクリプト一覧 | 指示書が名前を挙げたファイルが実在するか。逆に、実在するのに載っていないもの |
| 記事の状態 | 表の「公開済み / 下書き」が、APIが返す status と一致するか |
| 再利用ブロック | 各ブロックが何記事に入っているか。中身が空なのに参照されていないか |
いずれも読み取りだけで、書き込みは一切しません。
7.2 実際に走らせると出てくる
ブロックの設置数は、全記事を取得して本文から数え直します。
# 全記事の本文から、再利用ブロックの参照を数え直す
usage = {}
for p in posts:
    for ref in set(re.findall(r'wp:block \{"ref":(\d+)\}', p["content"]["raw"])):
        usage.setdefault(int(ref), []).append(p["id"])

# 中身が空なのに参照されている = あとで中身を入れると一斉に復活する
if size == 0 and len(usage.get(bid, [])):
findings.append(f"{bid}: 中身が空なのに {len(usage[bid])}記事から参照されている")走らせたところ、指示書に一行も書かれていないブロックが13記事に入っていることが分かりました。中身のある内部リンクカードで、リンク先も生きていたので実害はありませんでしたが、指示書だけを見て全体を把握したつもりになっていたのは事実です。
同じ仕組みで、先に触れた「中身が空なのに41記事から参照されているブロック」も検出できます。空のブロックは画面に何も表示しないので、記事を読んでも気づけません。数え直して初めて出てきます。
7.3 誤検出は潰しておく
最初に書いた版は、本文中に出てくる他製品のソースファイル名まで「実在しないスクリプト」として拾い、2件の誤検出を出しました。
# ファイル一覧の表のセルだけを見る。本文中の言及は拾わない
named = set(re.findall(r"^\|\s*`([A-Za-z0-9_]+\.(?:py|ps1))`\s*\|", md, re.M))誤検出が混ざる監査は、そのうち誰も読まなくなります。出力は「全部本物」の状態を保つほうが、件数が少なくても価値があります。
なお、この照合で分かるのは機械的に確かめられる範囲だけです。「なぜそうするか」の記述が古くなっていないかは検出できません。 あくまでズレに気づく入口として使うものです。
8. まとめ
AIエージェントに実データを触らせるときの指示書について、6週間の運用から得た型をまとめます。
- 破壊的な操作は指示書ではなくスクリプトで止める。 既定を dry-run にし、対象件数を表示し、前提が崩れていたら中止する
- 禁止には理由を書く。 理由があれば射程が分かり、状況が変わったときに判断できる
- 防げない副作用には復旧手順を書く。 「消える」という事実だけでは復旧できない
- 絶対に守る項目は増やさない。 数が増えると優先順位が消える
- 指示書は腐る。見直しも機械化する。 手作業の点検は続かないので、記述と実態の突合をスクリプトにする。誤検出は潰しておく
指示書は「読ませる文書」であると同時に、実行時には何の強制力も持たない文書です。強制力が必要なところはコードに落とす、という切り分けが要ります。
MCP を経由して社内の管理データを参照させる構成については、Claude CodeにMCP経由でNetBoxを接続するにまとめています。
コメント